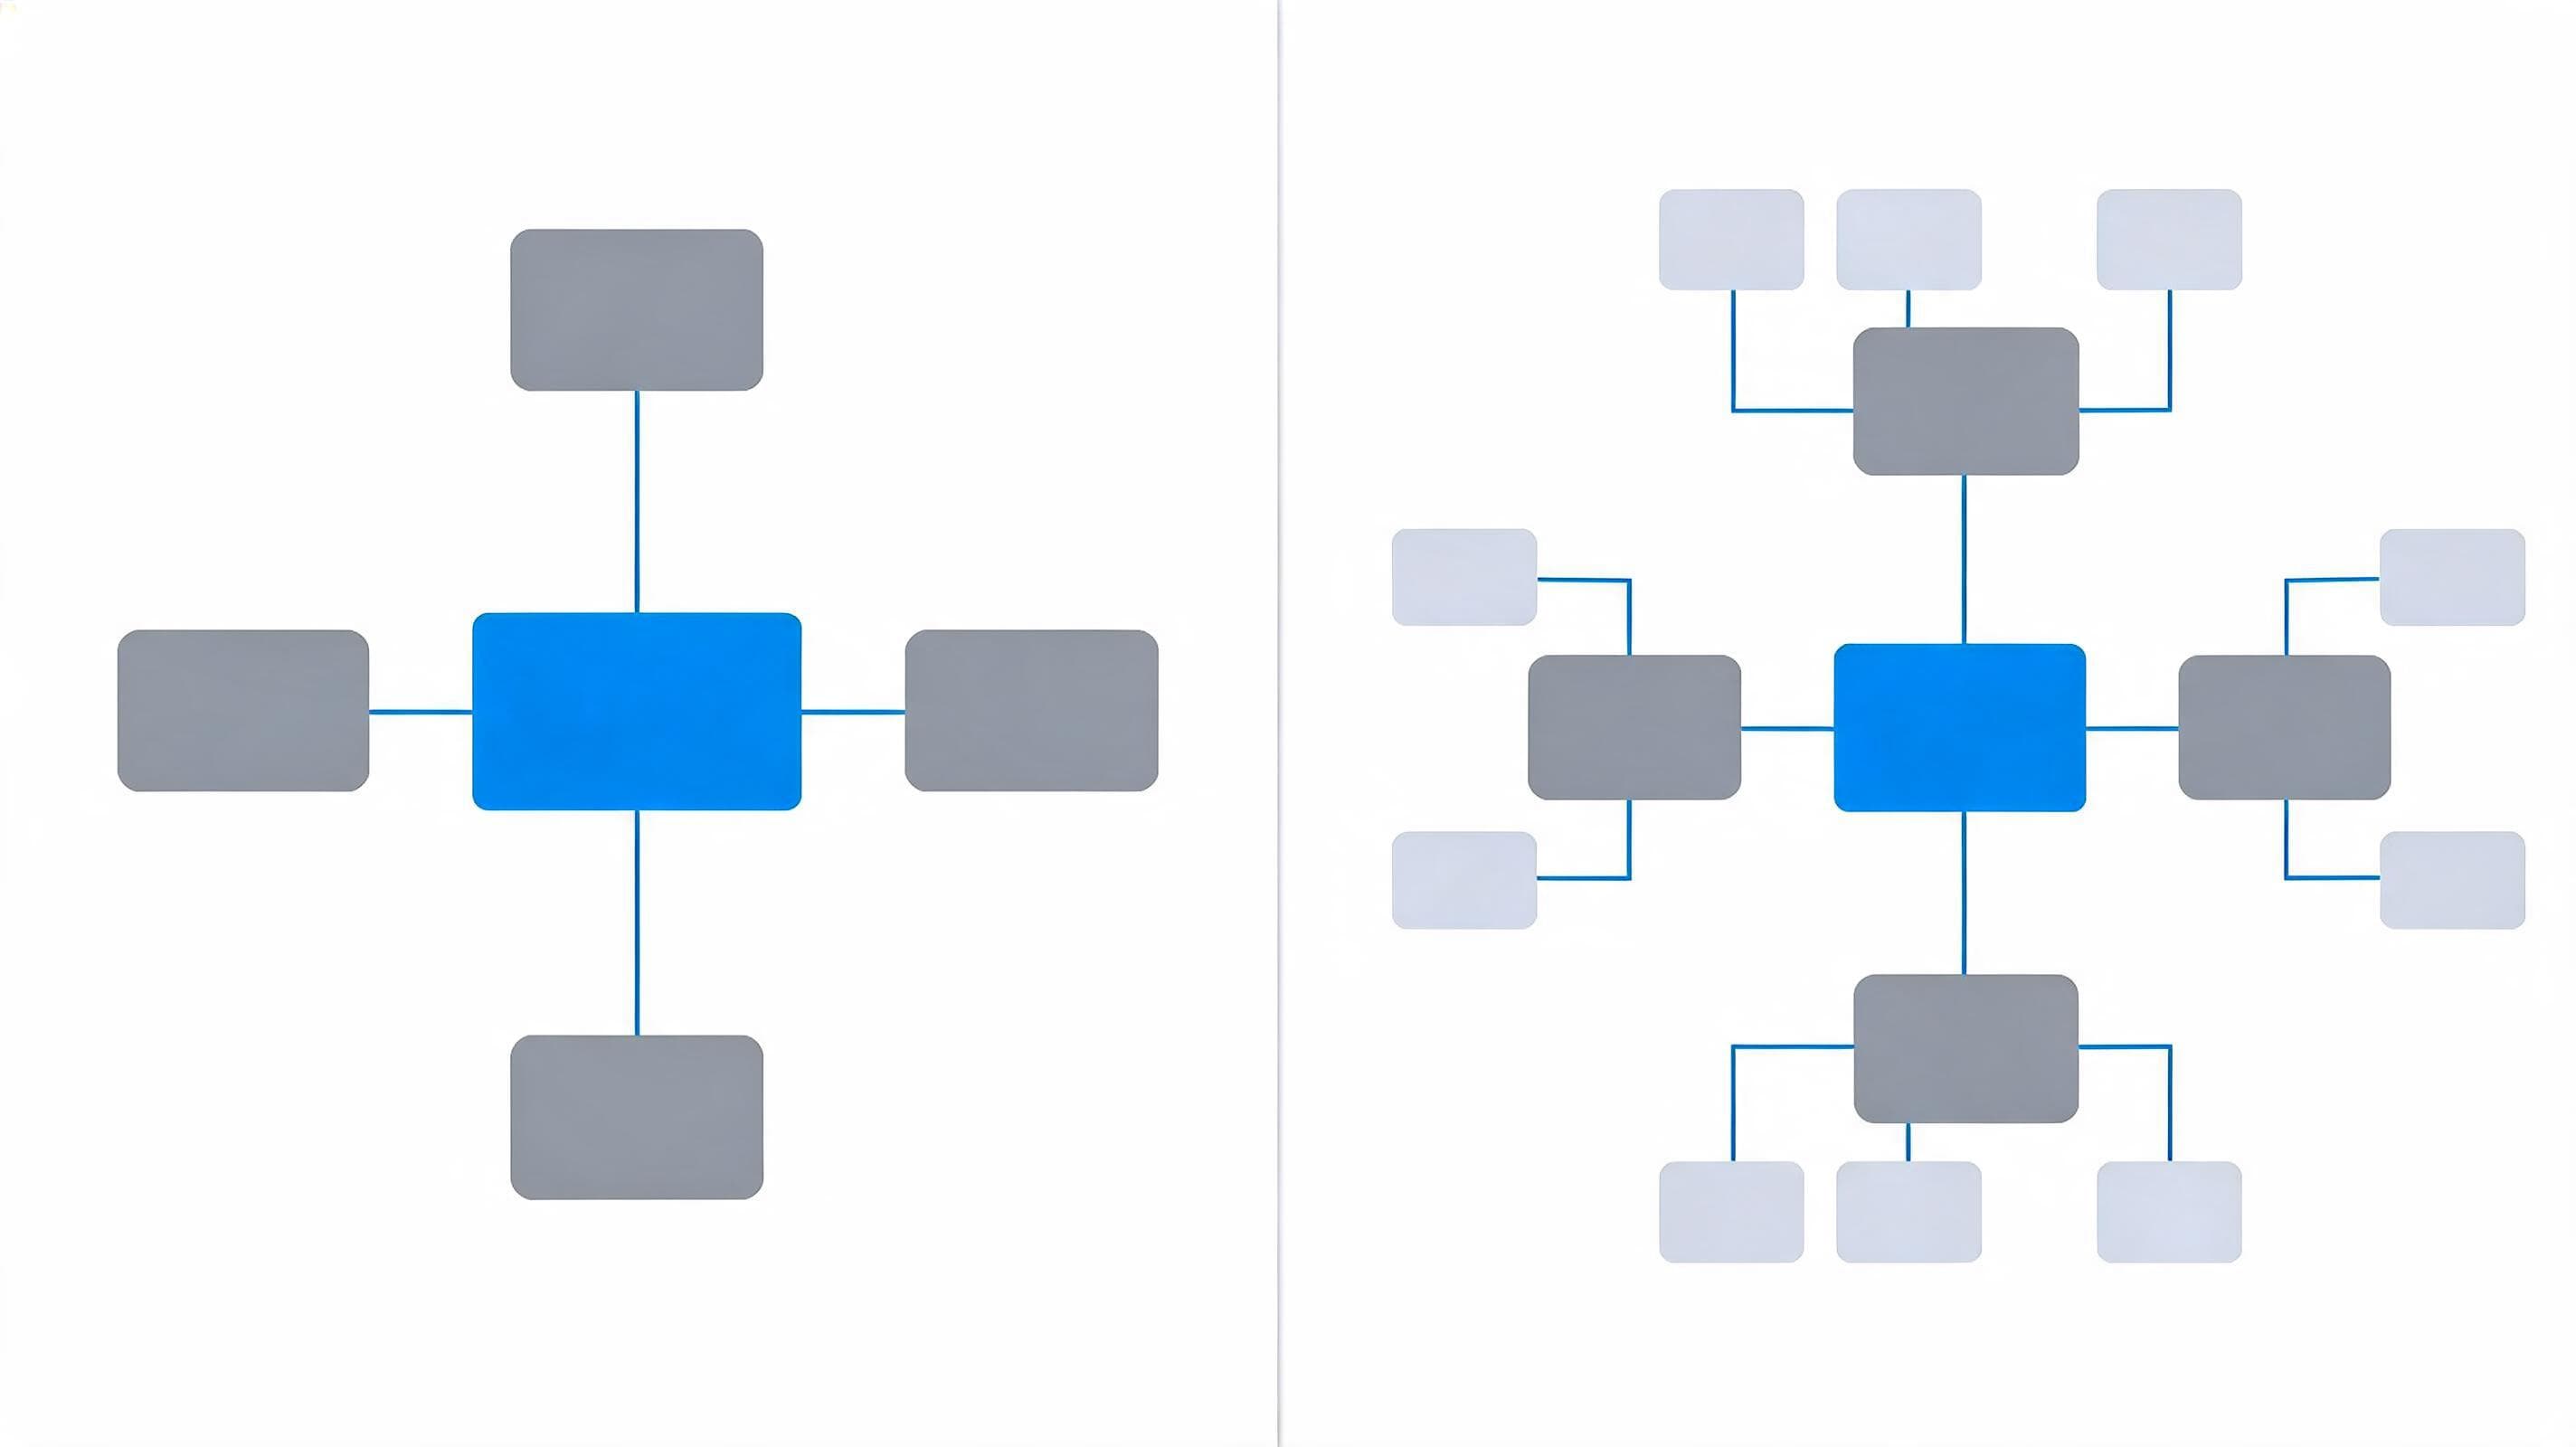
Snowflake vs star schema sorusunun kısa cevabı şudur: raporlama ve self servis analitik katmanında star schema, karmaşık hiyerarşilerin ve sık değişen ana verilerin yönetildiği katmanda ise snowflake schema daha doğru tercihtir. İki model de merkezde bir olgu (fact) tablosu ve çevresinde boyut (dimension) tabloları kullanır. Aralarındaki fark, boyut tablolarını ne kadar normalize ettiğinizdir. Bu karar sorgu hızını, bakım yükünü ve iş kullanıcılarının veriye ne kadar kolay ulaştığını doğrudan belirler.
Snowflake vs Star Schema: Temel Kavramlar
Boyutsal modellemede olgu tablosu ölçülebilir olayları tutar: bir kredi kullandırımı, bir poliçe tahsilatı ya da bir satış satırı gibi. Boyut tabloları ise bu olayı anlamlandıran bağlamı taşır: müşteri, şube, ürün, tarih. Her iki şema da bu temel yaklaşıma dayanır. Kavramın ayrıntılı çerçevesi için Kimball Group'un boyutsal modelleme teknikleri sayfası sektörde ortak bir başvuru noktasıdır.
Star schema nasıl kurulur?
Star schema'da her boyut tek ve geniş bir tablodur. Müşteri boyutunda müşterinin adı, segmenti, şehri ve bölgesi aynı satırda durur. Olgu tablosu bu boyutlara yalnızca birer anahtar ile bağlanır. Sonuç, yıldıza benzeyen sade bir yapıdır.
- Bir rapor sorgusu genellikle olgu tablosu ile birkaç boyutun JOIN'inden oluşur.
- Alan adları iş diline yakındır; analist neyi nerede bulacağını hızla öğrenir.
- Bedeli, boyut içindeki tekrar eden değerlerdir. Aynı bölge adı binlerce müşteri satırında yinelenir.
Snowflake schema nasıl kurulur?
Snowflake schema'da boyutlar hiyerarşi seviyelerine göre bölünür. Müşteri tablosu şehir tablosuna, şehir tablosu bölge tablosuna bağlanır. Her bilgi tek bir yerde tutulur. Bir bölgenin adı değiştiğinde yalnızca 1 satır güncellenir.
- Veri tekrarı azalır, referans bütünlüğü güçlenir.
- Derin ürün ağaçları ya da organizasyon hiyerarşileri doğal biçimde modellenir.
- Bedeli, daha fazla JOIN ve daha karmaşık bir semantik modeldir.
Karşılaştırma Tablosu: 6 Kriterde İki Model
Aşağıdaki tablo, kurumsal projelerde karar verirken en sık tartışılan kriterleri özetler. Mutlak bir kazanan yoktur; hangi kriterin sizin için ağır bastığına bakın.
| Kriter | Star schema | Snowflake schema |
|---|---|---|
| 1. Normalizasyon | Boyutlar denormalize, tek tablo | Boyutlar normalize, çok seviyeli |
| 2. Sorgu karmaşıklığı | Az JOIN, basit SQL | Daha çok JOIN, uzun sorgular |
| 3. Rapor performansı | Öngörülebilir ve genellikle hızlı | JOIN sayısına ve motora bağlı |
| 4. Veri tekrarı | Boyutlarda tekrar var | Tekrar en aza iner |
| 5. Bakım | Hiyerarşi değişikliği çok satırı etkiler | Değişiklik tek noktada yapılır |
| 6. Self servis kullanım | İş kullanıcısı için kolay | Semantik katman olmadan zor |
Sorgu performansı
Kolon tabanlı modern veri ambarı motorları JOIN maliyetini eskisine göre azalttı. Yine de pratikte gördüğümüz tablo değişmedi: rapor katmanında JOIN sayısı arttıkça yürütme planı karmaşıklaşır, önbellekleme zorlaşır ve bir dashboard'un açılış süresi kullanıcıdan kullanıcıya dalgalanır. Star schema bu dalgalanmayı azaltır.
Depolama ve maliyet
Snowflake schema'nın klasik avantajı disk tasarrufudur. Bulut depolamada bu avantaj eski önemini kaybetti; asıl maliyet artık hesaplama tarafında oluşur. Gereksiz JOIN'ler sorgu başına işlem süresini uzatır. Bu nedenle depolamadan tasarruf ederken hesaplamada kaybetmemek gerekir.
Maliyeti değerlendirirken tek bir sorguya değil, gün içindeki toplam iş yüküne bakın. Sabah saatlerinde aynı dashboard'u açan çok sayıda kullanıcı, her açılışta aynı JOIN zincirini yeniden çalıştırır. Rapor katmanını star schema olarak kurmak ve sık kullanılan özetleri önceden hesaplamak, bu tekrarlı yükü belirgin biçimde azaltmanın en güvenilir yoludur.
Veri bütünlüğü ve bakım
Bankacılık ve sigortacılıkta şube yapıları, ürün kırılımları ve regülasyon kodları sık değişir. Bu değişikliklerin tek noktadan yönetilmesi denetim izini de kolaylaştırır. Burada normalize yapı ve güçlü bir veri yönetimi disiplini birlikte çalışır.
Hangi Senaryoda Hangi Şema?
Kararı kolaylaştırmak için aşağıdaki kontrol listesini kullanabilirsiniz. Sorulara verdiğiniz cevaplar çoğunlukla bir tarafa yığılır.
- Star schema'yı seçin: Kullanıcıların çoğu iş birimlerinden geliyorsa, raporlar sürükle-bırak araçlarla hazırlanıyorsa ve dashboard yanıt süresi önceliğinizse.
- Snowflake schema'yı seçin: Boyutlarınız derin hiyerarşiler içeriyorsa, aynı referans veri birçok kaynaktan besleniyorsa ve değişikliklerin izlenebilirliği zorunluysa.
- İkisini katmanlı kullanın: Hem regülasyon raporlaması hem de geniş bir self servis kullanıcı kitlesi varsa.
Self servis analitik için star schema
İş kullanıcısı bir alanı ararken beş farklı tablo arasında gezinmek istemez. Self servis analitik projelerinde sunum katmanını star schema olarak kurmak, yanlış ilişki kurma riskini azaltır ve semantik modeli sade tutar.
Kurumsal veri ambarı için katmanlı yapı
Büyük kurumlarda en sağlıklı sonuç genellikle hibrit mimariden gelir. Entegrasyon ya da çekirdek katmanında veriler normalize tutulur. Sunum katmanında ise bu tablolardan konu bazlı star schema veri martları üretilir. Böylece bütünlük çekirdekte, hız ve kullanım kolaylığı sunumda sağlanır.
Uygulama Adımları: Modeli Seçmekten Canlıya Almaya
- Raporları envanterleyin. En çok kullanılan raporları ve her birinin ihtiyaç duyduğu boyutları listeleyin.
- Granülerliği belirleyin. Olgu tablosunun bir satırı neyi temsil ediyor? Bu cevap netleşmeden şema seçimi yapmayın.
- Hiyerarşileri haritalayın. Derin ve sık değişen hiyerarşileri işaretleyin; bunlar normalize çekirdek için adaydır.
- Sunum katmanını tasarlayın. İş zekası araçlarının okuyacağı star schema veri martlarını tanımlayın.
- Yavaş değişen boyut kurallarını yazın. Hangi alanların geçmişi tutulacak, hangileri üzerine yazılacak, baştan karar verin.
- Performansı ölçün. Bölümleme, özet tablolar ve materialized view'larla kritik raporları test edin; eski ve yeni sonuçları yan yana doğrulayın.
Yavaş Değişen Boyutlar İki Şemada Nasıl Yönetilir?
Model seçimini en çok zorlayan konu, zaman içinde değişen boyut verileridir. Bir müşterinin segmenti değiştiğinde geçmiş raporlar eski segmenti mi, yeni segmenti mi göstermeli? Bu soru iki şemada farklı karmaşıklık yaratır.
- Star schema'da: Geçmişi tutmak için boyut tablosuna yeni bir satır eklenir ve geçerlilik tarihleri ile güncel kayıt işareti kullanılır. Tek tablo olduğu için kural tek yerde yazılır; ancak geniş tabloda her değişiklik tüm niteliklerin kopyalanması anlamına gelir.
- Snowflake schema'da: Değişen seviye ayrı bir tabloda tutulduğu için yalnızca o seviye sürümlenir. Bu esneklik sağlar; buna karşılık bir raporun belirli bir tarihteki doğru görünümü için birden çok tablonun geçerlilik aralığını birlikte eşleştirmek gerekir.
Pratikte önerimiz, geçmişi izlenecek alanları proje başında iş birimiyle birlikte tek tek belirlemektir. Hangi alanın üzerine yazılacağı, hangisinin geçmişinin tutulacağı netleşmeden kurulan her model, ilk denetim raporunda yeniden ele alınmak zorunda kalır.
Sık yapılan 4 hata
- Kaynak sistemdeki normalize yapıyı olduğu gibi raporlama katmanına taşımak.
- Olgu tablosunda farklı granülerlikteki kayıtları aynı tabloda karıştırmak.
- Ortak boyutları (tarih, müşteri, şube) her veri martında ayrı ayrı ve farklı tanımlarla kurmak.
- Referans verinin sahibini belirlemeden boyut tablolarını beslemek.
BIART Bilişim'in Bakışı
Kurumsal projelerde deneyimimiz şunu gösteriyor: şema tartışması çoğu zaman yanlış soruyla başlar. Asıl soru “hangi model daha iyi” değil, “hangi katmanda hangi kullanıcıya hizmet ediyoruz” sorusudur. Teknoloji bağımsız yaklaşımımızla önce raporlama ihtiyacını ve veri sahipliğini netleştiriyor, ardından çekirdekte bütünlüğü, sunumda sadeliği koruyan katmanlı bir yapı öneriyoruz.
Sık yapılan hatalar da bu bakışı doğrular: tüm ambarı tek bir şemaya zorlamak, granülerliği belirsiz bırakmak ve semantik katmanı ihmal etmek. Bu üç hatadan kaçınmak, model seçiminden daha fazla fark yaratır.
Veri ambarı mimarinizi birlikte değerlendirmek isterseniz projeniz için birlikte çalışalım. İletişime geçin.
Sık sorulan sorular
Star schema ile snowflake schema arasındaki temel fark nedir?
Fark, boyut tablolarının normalizasyon düzeyindedir. Star schema'da her boyut tek ve geniş bir tablodur; snowflake schema'da boyutlar hiyerarşi seviyelerine göre birbirine bağlı alt tablolara bölünür. Bu yüzden star schema daha az JOIN ile sorgulanır, snowflake schema ise tekrarı azaltır.
Hangi model daha hızlı sorgu sağlar?
Genellikle star schema. Sorgu motoru olgu tablosunu doğrudan boyutlara bağlar ve yürütme planı basit kalır. Snowflake schema'da ek JOIN adımları oluşur; modern kolon tabanlı motorlarda bu fark küçülse de rapor katmanında star schema daha öngörülebilir davranır.
Self servis BI araçları için hangi şema önerilir?
Self servis analitikte star schema önerilir. İş kullanıcıları alanları tek bir boyut tablosunda bulur, yanlış ilişki kurma riski azalır ve semantik model sade kalır. Normalize kaynaklar varsa bunlar görünüm ya da ETL adımıyla düzleştirilip kullanıcıya star yapı olarak sunulmalıdır.
İki model aynı veri ambarında birlikte kullanılabilir mi?
Evet ve kurumsal projelerde en sık görülen yapı budur. Çekirdek ya da entegrasyon katmanında normalize (snowflake benzeri) tablolar tutulur, sunum katmanında ise bu tablolardan üretilen star schema veri martları raporlamaya açılır.
Mevcut bir snowflake modeli star schema'ya nasıl dönüştürülür?
Önce en çok kullanılan raporlar ve onların boyutları belirlenir. Ardından alt tablolar ana boyut tablosuna düzleştirilir, vekil anahtarlar korunur, yavaş değişen boyut kuralları yeniden test edilir ve eski ile yeni modelin rapor sonuçları yan yana karşılaştırılarak geçiş yapılır.