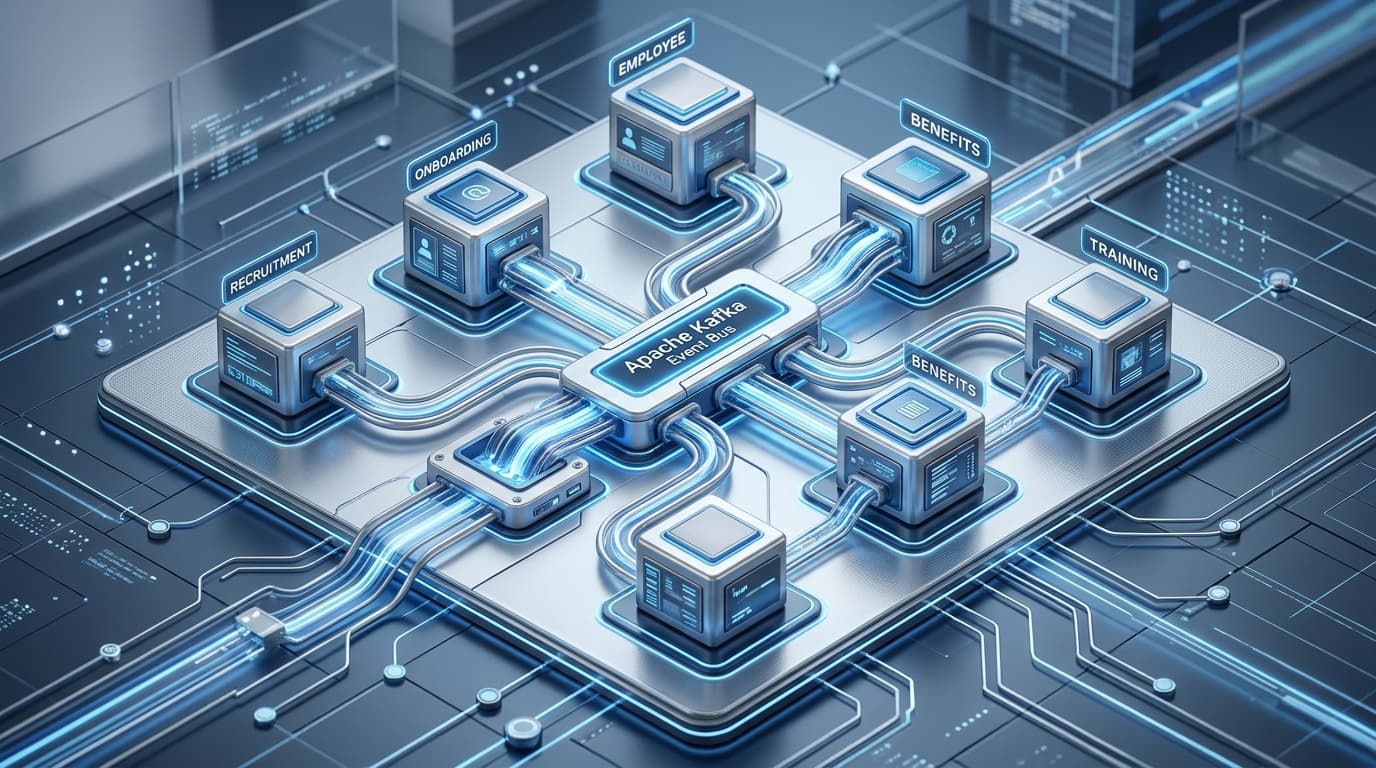
Масштабируемые HR-системы на микросервисной архитектуре и Kafka — это разделение таких процессов, как расчёт заработной платы, отпуска, подбор и оценка персонала, на независимые сервисы с событийным и асинхронным взаимодействием между ними. Благодаря этому перегрузка или сбой одного сервиса не останавливает остальные, а каждый процесс растёт в соответствии со своими потребностями.
Почему монолитная HR-система упирается в предел?
В цельных HR-программах расчёт зарплаты, согласование отпусков и кадровые записи используют одну и ту же базу данных. В период пиковой нагрузки по расчёту зарплаты в конце месяца замедляется и экран отпусков. Даже небольшое изменение требует повторного выпуска всего приложения. По мере роста организации такой подход создаёт проблемы и со скоростью, и с надёжностью.
- Одна ошибка может затронуть все модули.
- Масштабировать только перегруженный модуль невозможно.
- Интеграция с такими системами, как SAP, Logo или Netsis, становится жёстко связанной.
- Для новой функции все команды зависят от одного графика релизов.
Как проектировать масштабируемые HR-системы на микросервисной архитектуре и Kafka?
Первый шаг — провести границы сервисов по бизнес-областям. Каждый сервис владеет своими данными и не обращается напрямую к базе данных другого сервиса. Этот принцип согласуется с логикой независимого развёртывания, описанной в статье Мартина Фаулера о микросервисах. При проведении границ должен быть чёткий ответ на вопрос: «если эти данные изменятся, какая команда за это отвечает?».
Пример разделения сервисов
| Сервис | Ответственность | Публикуемое событие |
|---|---|---|
| Кадровый сервис | Учёт сотрудников и организационная структура | EmployeeHired, EmployeeTransferred |
| Сервис отпусков | Заявки на отпуск и процесс согласования | LeaveApproved |
| Сервис расчёта зарплаты | Расчёт зарплаты и удержаний | PayrollCalculated |
| Сервис подбора персонала | База кандидатов и процесс оффера | OfferAccepted |
| Сервис уведомлений | Уведомления по электронной почте и в приложении | Потребляет события |
Роль Kafka
В такой архитектуре Kafka работает как очередь сообщений и постоянный журнал событий. Один сервис публикует событие, заинтересованные сервисы читают его в собственном темпе. Поскольку топики разделены на партиции (partition), число потребителей, читающих один топик, можно горизонтально увеличивать по мере роста нагрузки. Использование номера сотрудника в качестве ключа сообщения — распространённый способ сохранить порядок событий, относящихся к одному сотруднику. За техническими подробностями стоит обратиться к официальной документации Apache Kafka.
Как асинхронный процесс работает на практике?
Рассмотрим приём нового сотрудника на работу. Процесс проходит следующие шаги:
- Сервис подбора персонала публикует событие OfferAccepted, кадровый сервис создаёт запись.
- Кадровый сервис записывает событие EmployeeHired в соответствующий топик Kafka.
- Сервис расчёта зарплаты читает событие и открывает запись о зарплате.
- Сервис отпусков определяет право на ежегодный отпуск.
- Сервис уведомлений отправляет сообщения руководителю и сотруднику.
Кадровый сервис не ждёт ответа остальных. Даже если сервис расчёта зарплаты временно недоступен, событие не теряется: когда сервис вернётся, он продолжит с того места, где остановился. Если в прежней архитектуре одна ошибка отменяла весь приём на работу, то здесь повторяется только соответствующий шаг.
Обработка ошибок и согласованность данных
В распределённой архитектуре не каждый шаг может завершиться успешно. Поэтому вместо одной большой операции нужны процессы с компенсирующими шагами. Этот подход описывает паттерн Saga: если один шаг завершился неудачей, предыдущие шаги откатываются.
- Идемпотентный потребитель: если одно и то же сообщение придёт дважды, результат не должен измениться.
- Топик dead letter: сообщения, которые не удалось обработать, помещаются в отдельный топик и анализируются.
- Политика повторных попыток: при временных ошибках выполняется контролируемый повтор.
- Наблюдаемость: для каждого события хранится идентификатор процесса, что позволяет быстро найти источник ошибки.
На практике чаще всего ошибаются, проектируя события только для «успешного» сценария. В потоках, связанных с деньгами, таких как расчёт зарплаты, мы советуем сначала продумать сценарии ошибок, то есть шаги отката и повторной обработки. Этот подход — самый полезный урок из нашего опыта работы с корпоративными платформами данных.
Безопасность и соответствие KVKK
Данные HR — это персональные данные. В содержимом события следует передавать только необходимые поля, а чувствительную информацию маскировать или передавать по ссылке на идентификатор. Права доступа определяются на уровне сервисов, а журналы должны оставаться доступными для аудита. Чтобы отследить путь данных, обратитесь к нашему руководству по происхождению данных и data trust. Также рекомендуем следить за обязанностями по защите персональных данных на официальном сайте KVKK.
На что обратить внимание при внедрении
- Начинайте с малого: сначала выделите малорисковый сервис, например уведомления или отпуска.
- Версионируйте схемы событий; добавляйте поля, не ломая потребителей.
- Не отказывайтесь от существующей инфраструктуры SAP, Logo или Netsis, а генерируйте события через интеграционный слой.
- Настройте мониторинг и оповещения с первого дня.
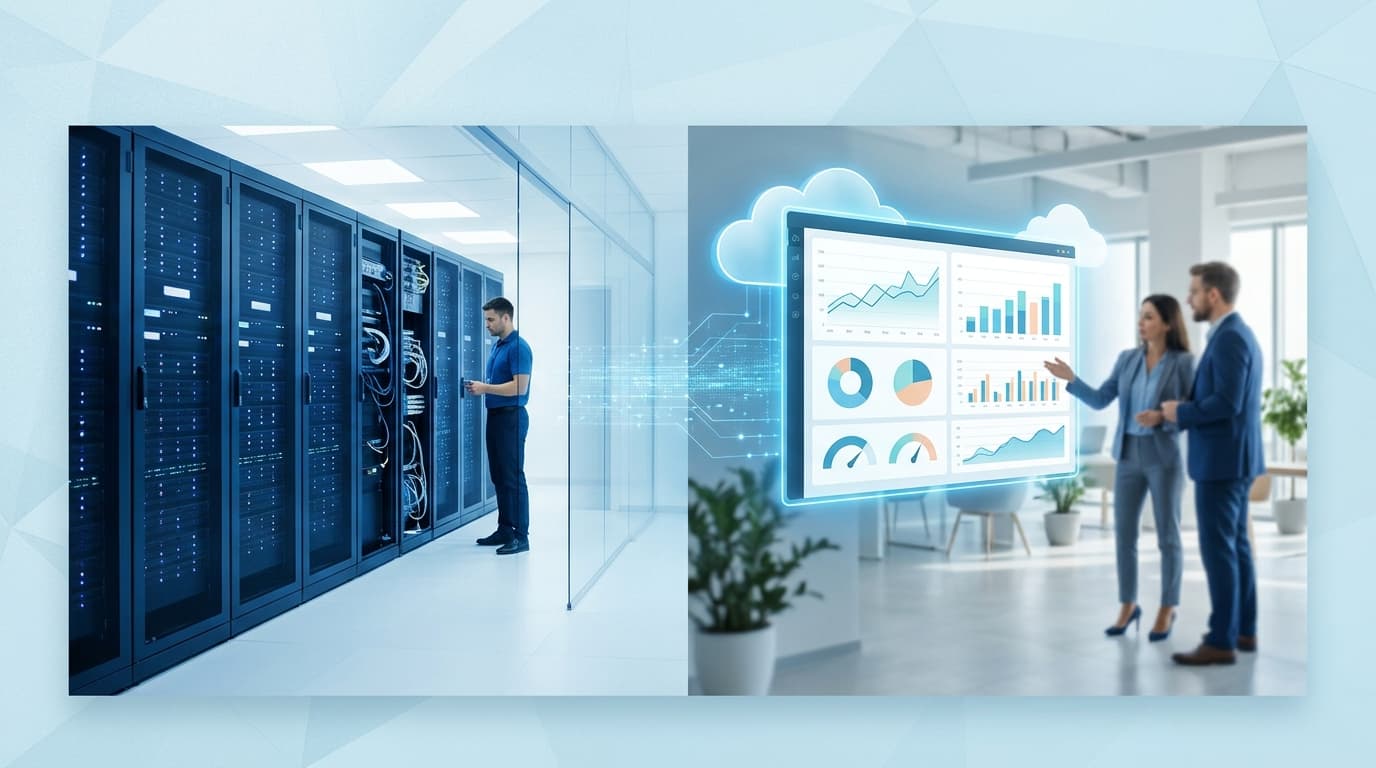
- Заранее решите, будет ли инфраструктура работать в облаке или в вашем собственном центре обработки данных.
Вместо одномоментного перехода лучше двигаться подходом «strangler», модуль за модулем — это снижает риск. На каждом шаге некоторое время запускайте старый и новый процессы параллельно и сравнивайте результаты, а старый модуль отключайте только тогда, когда результаты совпадают. Также с самого начала чётко распределите ответственность между командами: у каждого сервиса должны быть владелец, график дежурств и документация.
BIART Bilişim предлагает технологически независимый подход с услугами платформ больших данных на базе Kafka, облачных решений и разработки программного обеспечения на заказ. Наш опыт в корпоративных проектах вы можете увидеть на странице референсов. Давайте поработаем над вашим проектом вместе. Свяжитесь с нами.
Часто задаваемые вопросы
Обязательна ли микросервисная архитектура для HR-систем?
Нет. В небольших организациях со стабильной нагрузкой может хватить цельной архитектуры. Микросервисы имеют смысл, если модули растут с разной скоростью и нужны независимые релизы.
Для чего Kafka нужна в HR-процессах?
Она обеспечивает событийное асинхронное взаимодействие между сервисами. Даже если сервис временно недоступен, сообщения сохраняются и обрабатываются позже.
Нужно ли отказываться от существующей системы SAP или Logo?
Нет. Существующая система может генерировать события через интеграционный слой, а новые сервисы — потреблять эти события.
Как обеспечивается согласованность данных?
Согласованность обеспечивается компенсирующими шагами в стиле Saga, идемпотентными потребителями и топиками dead letter.
На что обратить внимание с точки зрения KVKK?
В событиях следует передавать только необходимые поля, чувствительные данные маскировать, а также вести доступ на уровне сервисов и журналы аудита.