Консалтинг по корпоративному ИИ: проверяемый, безопасный и основанный на ваших данных
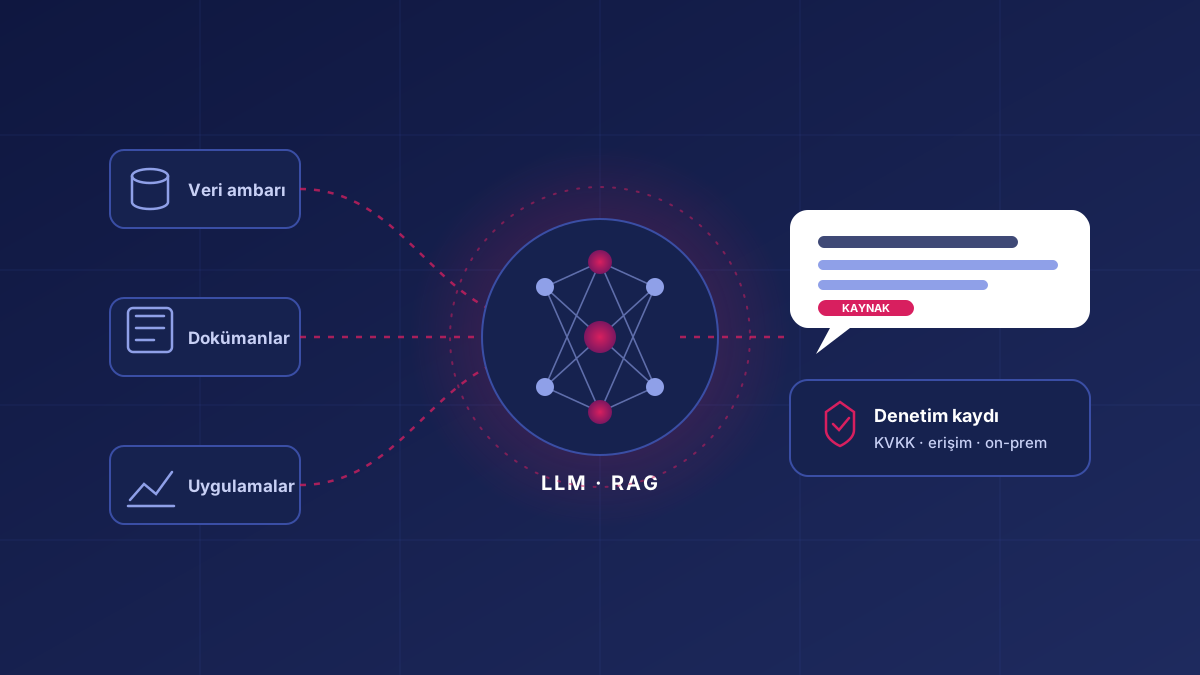
Услуга BIART по консалтингу в области искусственного интеллекта предназначена для банков и крупных организаций, которые хотят вывести генеративный ИИ (GenAI) и большие языковые модели (LLM) за рамки экспериментов и безопасно запустить их в продакшен. Создавая корпоративные ИИ-решения, мы ставим в центр не модель, а данные организации, её процессы и регуляторные ограничения. Результат — ИИ-приложения, которые опираются на корректные данные, показывают источники, фиксируют, кто к чему обращался, и при необходимости работают полностью внутри периметра (on-prem).
Когда к нам обращаются?
- Руководство ждёт конкретный сценарий использования генеративного ИИ и бизнес-обоснование, но неясно, с чего начать.
- Нужен ассистент, отвечающий на вопросы по внутренним документам, регламентам и политикам (RAG).
- Из-за клиентских или конфиденциальных данных нельзя отправлять информацию в публичные облачные ИИ-сервисы — требуется on-prem LLM.
- Существующий чат-бот или пилот LLM даёт неверные, неподтверждённые или противоречивые ответы.
- Аналитики и руководители хотят задавать вопросы к данным на естественном языке без SQL.
- Комплаенс, риск-менеджмент и внутренний аудит спрашивают, как будет контролироваться и ограничиваться использование ИИ.
Что это даёт
- Надёжные ответы
опираются на ваши данные и документы и показывают источники.
- Суверенитет данных
варианты моделей и инфраструктуры, при которых чувствительные данные не покидают организацию.
- Проверяемость
каждый запрос, использованный источник и решение модели фиксируются в журнале.
- Измеримая ценность
сценарии отслеживаются по метрикам успеха, заданным для каждого процесса.
Что мы делаем
- Стратегия ИИ и воркшоп по сценариям
список сценариев, приоритизированный по бизнес-ценности, готовности данных и рискам.
- Интеграция LLM
подключение больших языковых моделей к CRM, контакт-центру, системам документооборота и внутренним порталам через API и события.
- Корпоративные ассистенты на базе RAG
обработка документов, векторный поиск, извлечение с учётом прав доступа и ссылки на источники.
- Инфраструктура on-prem LLM
развёртывание моделей внутри периметра на open-source компонентах Ollama, vLLM и TEI, планирование GPU-мощностей и мониторинг.
- Разработка корпоративных чат-ботов и ИИ-агентов
ассистенты для сотрудников и клиентов, агенты, выполняющие процессы пошагово с точками подтверждения человеком.
- Вопросы к данным на естественном языке (Text-to-SQL)
проверяемая генерация SQL с семантическим слоем и контролем прав.
- MLOps и жизненный цикл моделей
версионирование, мониторинг и переобучение моделей прогнозирования, скоринга и поиска аномалий.
- Управление ИИ (AI governance)
политики использования, маскирование персональных данных, контроль запросов и ответов, наборы для оценки качества.
Наш подход
- Анализ и приоритизация
совместно определяются сценарии, источники данных, пользователи и регуляторные ограничения.
- Подготовка данных и архитектуры
измеряется качество исходных данных; выбираются модель, среда размещения и архитектура безопасности.
- Контролируемый пилот
проверка на ограниченной группе пользователей по заранее заданным метрикам точности и использования.
- Вывод в продакшен
аутентификация, авторизация, журналирование, мониторинг затрат и производительности.
- Постоянное улучшение
качество ответов регулярно измеряется на оценочных наборах; новые сценарии добавляются на ту же платформу.
Модели сотрудничества
- Проектная поставка
проекты ассистентов, интеграций или платформ с заранее определёнными объёмом и критериями приёмки.
- Усиление команды
инженеры LLM, данных и MLOps в составе вашей ИИ- или дата-команды. Подробнее — на странице аутсорсинга.
- Управляемый сервис
мониторинг ИИ-приложений в продакшене, обновление моделей и поддержка пользователей.
Почему BIART?
- Технологическая независимость
мы не привязаны к одному поставщику моделей и рекомендуем open-source, коммерческие и облачные модели исходя из задачи, стоимости и чувствительности данных.
- Сначала доверие к данным
ИИ хорош настолько, насколько хороши данные. В собственном продукте CentraQL мы создали AI Copilot, который измеряет качество данных, отслеживает их происхождение и проверяемо отвечает на вопросы на естественном языке, — и переносим этот подход в проекты клиентов.
- Опыт в банках и регулируемых отраслях
требования KVKK, GDPR и BDDK, маскирование персональных данных и журналирование доступа закладываются в архитектуру с первого дня.
- Полный цикл
вместе с командами управления данными, больших данных и заказной разработки мы подключаем ИИ к вашим существующим системам.
- Команды в Стамбуле и Баку
ведём проекты в Турции и Азербайджане с локальными командами на русском, английском, турецком и азербайджанском языках.
Как формируется стоимость?
Каждый ИИ-проект уникален, поэтому вместо фиксированного прайса мы готовим предложение под конкретный объём. Основные факторы:
- Количество и сложность сценариев
один ассистент по документам или агенты, подключённые к нескольким системам?
- Источники данных
объём документов, структурированные источники и готовность данных.
- Среда размещения
on-prem GPU-инфраструктура, частное облако или управляемые сервисы моделей.
- Требования безопасности и комплаенса
маскирование, контроль доступа, журналирование и объём аудита.
- Число пользователей и интенсивность
объём обращений к модели и ожидания по производительности.
- SLA
часы поддержки, ожидаемое время реакции и объём управляемого сервиса.
Читайте также
- 3 способа интеграции LLM в бизнес-процессы
- RAG-архитектура: корпоративные знания для генеративного ИИ
- On-prem LLM для банков: Ollama, vLLM и TEI
- ИИ-агенты в корпоративных процессах: пять сценариев
Запустите ИИ в продакшен уверенно
Давайте вместе оценим ваши сценарии, данные и регуляторные ограничения. Свяжитесь с командой BIART, чтобы определить правильную точку старта и модель сотрудничества.