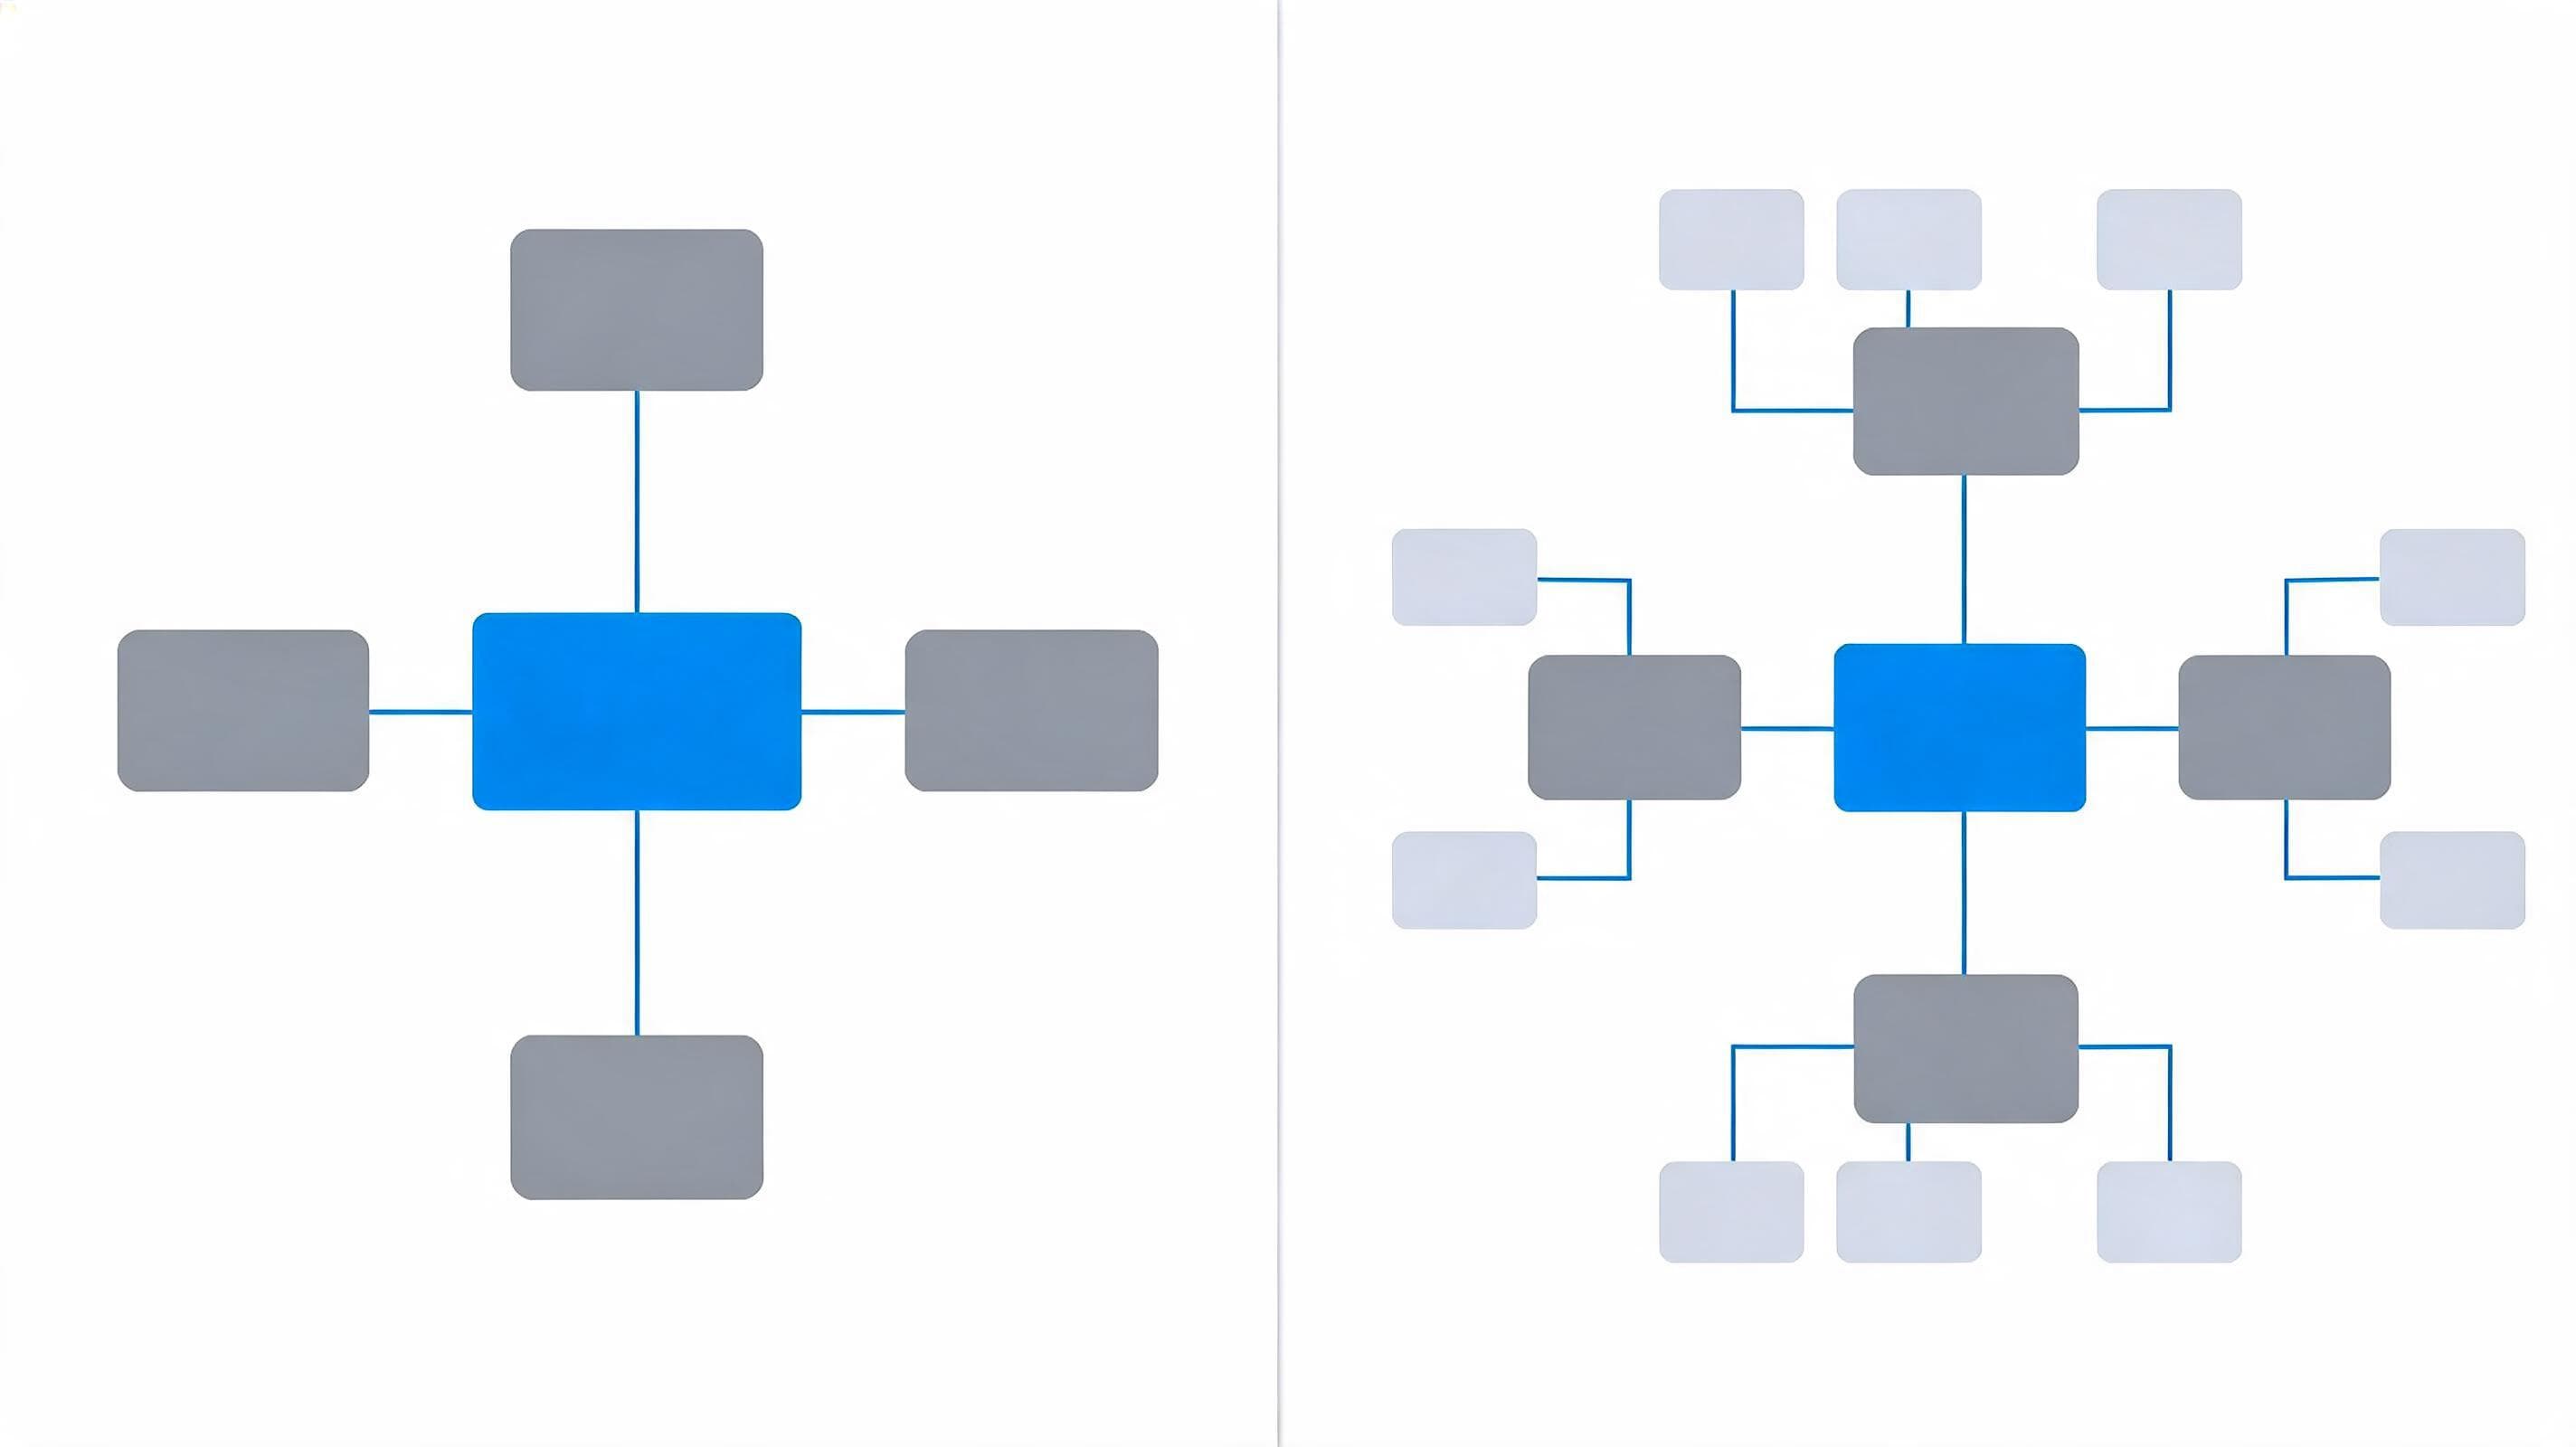
Короткий ответ на вопрос snowflake vs star schema таков: для слоя отчетности и self-service аналитики лучше подходит star schema, а для слоя, где управляются сложные иерархии и часто меняющиеся мастер-данные, — snowflake schema. Обе модели используют в центре таблицу фактов (fact), окруженную таблицами измерений (dimension). Разница между ними в том, насколько сильно вы нормализуете таблицы измерений. Это решение напрямую определяет скорость запросов, нагрузку на сопровождение и то, насколько легко бизнес-пользователи получают доступ к данным.
Snowflake vs Star Schema: базовые понятия
В многомерном моделировании таблица фактов хранит измеримые события: выдачу кредита, сбор страховой премии или строку продажи. Таблицы измерений несут контекст, который придает событию смысл: клиент, филиал, продукт, дата. Обе схемы опираются на этот базовый подход. Общепринятым отраслевым ориентиром для подробного описания концепции служит страница «Техники многомерного моделирования» Kimball Group.
Как строится star schema?
В star schema каждое измерение — одна широкая таблица. В измерении клиентов имя клиента, сегмент, город и регион находятся в одной строке. Таблица фактов связывается с каждым из этих измерений всего одним ключом. В результате получается простая структура, напоминающая звезду.
- Запрос отчета обычно состоит из JOIN таблицы фактов с несколькими измерениями.
- Названия полей близки к языку бизнеса; аналитик быстро запоминает, где что искать.
- Цена этого — повторяющиеся значения внутри измерения. Одно и то же название региона повторяется в тысячах строк клиентов.
Как строится snowflake schema?
В snowflake schema измерения разделяются по уровням иерархии. Таблица клиентов связана с таблицей городов, а таблица городов — с таблицей регионов. Каждый элемент информации хранится только в одном месте. При изменении названия региона обновляется лишь 1 строка.
- Дублирование данных снижается, ссылочная целостность усиливается.
- Глубокие продуктовые деревья или организационные иерархии моделируются естественным образом.
- Цена этого — больше JOIN и более сложная семантическая модель.
Сравнительная таблица: две модели по 6 критериям
В таблице ниже собраны критерии, которые чаще всего обсуждаются при принятии решений в корпоративных проектах. Абсолютного победителя нет; смотрите, какой критерий для вас весомее.
| Критерий | Star schema | Snowflake schema |
|---|---|---|
| 1. Нормализация | Измерения денормализованы, одна таблица | Измерения нормализованы, многоуровневые |
| 2. Сложность запросов | Мало JOIN, простой SQL | Больше JOIN, длинные запросы |
| 3. Производительность отчетов | Предсказуемая и обычно высокая | Зависит от числа JOIN и движка |
| 4. Дублирование данных | В измерениях есть дублирование | Дублирование сведено к минимуму |
| 5. Сопровождение | Изменение иерархии затрагивает много строк | Изменение вносится в одном месте |
| 6. Использование в self-service | Просто для бизнес-пользователя | Сложно без семантического слоя |
Производительность запросов
Современные колоночные движки хранилищ данных снизили стоимость JOIN по сравнению с прошлым. Тем не менее картина, которую мы видим на практике, не изменилась: с ростом числа JOIN в слое отчетности план выполнения усложняется, кэширование затрудняется, а время открытия дашборда колеблется от пользователя к пользователю. Star schema уменьшает эти колебания.
Хранение и стоимость
Классическое преимущество snowflake schema — экономия дискового пространства. В облачном хранении это преимущество утратило прежнее значение; основные затраты теперь возникают на стороне вычислений. Лишние JOIN увеличивают время обработки каждого запроса. Поэтому, экономя на хранении, важно не проиграть на вычислениях.
Оценивая стоимость, смотрите не на отдельный запрос, а на общую нагрузку за день. Множество пользователей, открывающих утром один и тот же дашборд, при каждом открытии заново запускают одну и ту же цепочку JOIN. Построение слоя отчетности по star schema и предварительный расчет часто используемых агрегатов — самый надежный способ заметно снизить эту повторяющуюся нагрузку.
Целостность данных и сопровождение
В банковском и страховом секторах структуры филиалов, продуктовые разрезы и регуляторные коды меняются часто. Управление этими изменениями из одной точки также упрощает ведение аудиторского следа. Здесь нормализованная структура и строгая дисциплина управления данными работают вместе.
Какая схема для какого сценария?
Чтобы упростить решение, воспользуйтесь чек-листом ниже. Ответы на вопросы, как правило, складываются в пользу одной из сторон.
- Выбирайте star schema: если большинство пользователей — из бизнес-подразделений, отчеты создаются в drag-and-drop инструментах, а время отклика дашбордов — ваш приоритет.
- Выбирайте snowflake schema: если ваши измерения содержат глубокие иерархии, одни и те же справочные данные поступают из многих источников, а отслеживаемость изменений обязательна.
- Используйте обе схемы в разных слоях: если у вас есть и регуляторная отчетность, и широкая аудитория self-service пользователей.
Star schema для self-service аналитики
Бизнес-пользователь, который ищет нужное поле, не хочет переходить между пятью разными таблицами. В проектах self-service аналитики построение слоя представления по star schema снижает риск создания неверных связей и сохраняет семантическую модель простой.
Многослойная структура для корпоративного хранилища данных
В крупных организациях наилучший результат обычно дает гибридная архитектура. В слое интеграции или ядра данные хранятся в нормализованном виде. В слое представления из этих таблиц формируются предметно-ориентированные витрины данных по star schema. Так целостность обеспечивается в ядре, а скорость и удобство использования — в слое представления.
Шаги внедрения: от выбора модели до запуска в эксплуатацию
- Проведите инвентаризацию отчетов. Составьте список наиболее используемых отчетов и измерений, необходимых каждому из них.
- Определите гранулярность. Что представляет собой одна строка таблицы фактов? Не выбирайте схему, пока ответ на этот вопрос не станет ясен.
- Составьте карту иерархий. Отметьте глубокие и часто меняющиеся иерархии; это кандидаты для нормализованного ядра.
- Спроектируйте слой представления. Определите витрины данных по star schema, которые будут читать инструменты бизнес-аналитики.
- Пропишите правила для медленно меняющихся измерений. Заранее решите, для каких полей будет храниться история, а какие будут перезаписываться.
- Измерьте производительность. Протестируйте критичные отчеты с партиционированием, агрегатными таблицами и materialized view; сверьте старые и новые результаты параллельно.
Как управлять медленно меняющимися измерениями в двух схемах?
Больше всего выбор модели усложняют данные измерений, которые меняются со временем. Когда меняется сегмент клиента, должны ли исторические отчеты показывать старый сегмент или новый? В двух схемах этот вопрос создает сложность разного рода.
- В star schema: для хранения истории в таблицу измерения добавляется новая строка, используются даты действия и признак текущей записи. Поскольку таблица одна, правило описывается в одном месте; однако в широкой таблице каждое изменение означает копирование всех атрибутов.
- В snowflake schema: поскольку изменяющийся уровень хранится в отдельной таблице, версионируется только этот уровень. Это дает гибкость; зато для корректного представления отчета на определенную дату приходится совместно сопоставлять интервалы действия нескольких таблиц.
На практике мы рекомендуем в начале проекта вместе с бизнес-подразделением поименно определить поля, история которых будет отслеживаться. Любую модель, построенную до того, как станет ясно, какое поле будет перезаписываться, а для какого будет храниться история, придется пересматривать уже при первом аудиторском отчете.
4 распространенные ошибки
- Переносить нормализованную структуру исходной системы в слой отчетности как есть.
- Смешивать в одной таблице фактов записи разной гранулярности.
- Строить общие измерения (дата, клиент, филиал) отдельно в каждой витрине данных и с разными определениями.
- Наполнять таблицы измерений, не определив владельца справочных данных.
Взгляд BIART Bilişim
Наш опыт в корпоративных проектах показывает: дискуссия о схеме часто начинается с неправильного вопроса. Главный вопрос не «какая модель лучше», а «какому пользователю и в каком слое мы служим». Придерживаясь технологически независимого подхода, мы сначала уточняем потребности в отчетности и распределение владения данными, а затем предлагаем многослойную структуру, которая сохраняет целостность в ядре и простоту в слое представления.
Распространенные ошибки подтверждают этот взгляд: попытка втиснуть все хранилище в одну схему, неопределенная гранулярность и пренебрежение семантическим слоем. Если избежать этих трех ошибок, эффект будет больше, чем от самого выбора модели.
Если вы хотите вместе оценить архитектуру вашего хранилища данных, давайте поработаем над вашим проектом вместе. Свяжитесь с нами.
Часто задаваемые вопросы
В чем основное различие между star schema и snowflake schema?
Различие — в уровне нормализации таблиц измерений. В star schema каждое измерение — одна широкая таблица; в snowflake schema измерения разбиваются на связанные между собой подтаблицы по уровням иерархии. Поэтому star schema запрашивается с меньшим числом JOIN, а snowflake schema снижает дублирование.
Какая модель обеспечивает более быстрые запросы?
Как правило, star schema. Движок запросов связывает таблицу фактов напрямую с измерениями, и план выполнения остается простым. В snowflake schema появляются дополнительные шаги JOIN; хотя на современных колоночных движках эта разница сокращается, в слое отчетности star schema ведет себя более предсказуемо.
Какую схему рекомендуется использовать для self-service BI-инструментов?
Для self-service аналитики рекомендуется star schema. Бизнес-пользователи находят поля в одной таблице измерения, риск создания неверных связей снижается, а семантическая модель остается простой. Если есть нормализованные источники, их следует «уплощить» с помощью представления (view) или шага ETL и предоставить пользователю в виде звездной структуры.
Можно ли использовать обе модели в одном хранилище данных?
Да, и это самая распространенная структура в корпоративных проектах. В слое ядра или интеграции хранятся нормализованные (похожие на snowflake) таблицы, а в слое представления для отчетности открываются витрины данных по star schema, сформированные из этих таблиц.
Как преобразовать существующую модель snowflake в star schema?
Сначала определяются наиболее используемые отчеты и их измерения. Затем подтаблицы «уплощаются» в основную таблицу измерения, суррогатные ключи сохраняются, правила медленно меняющихся измерений тестируются заново, а переход выполняется после параллельного сравнения результатов отчетов старой и новой моделей.